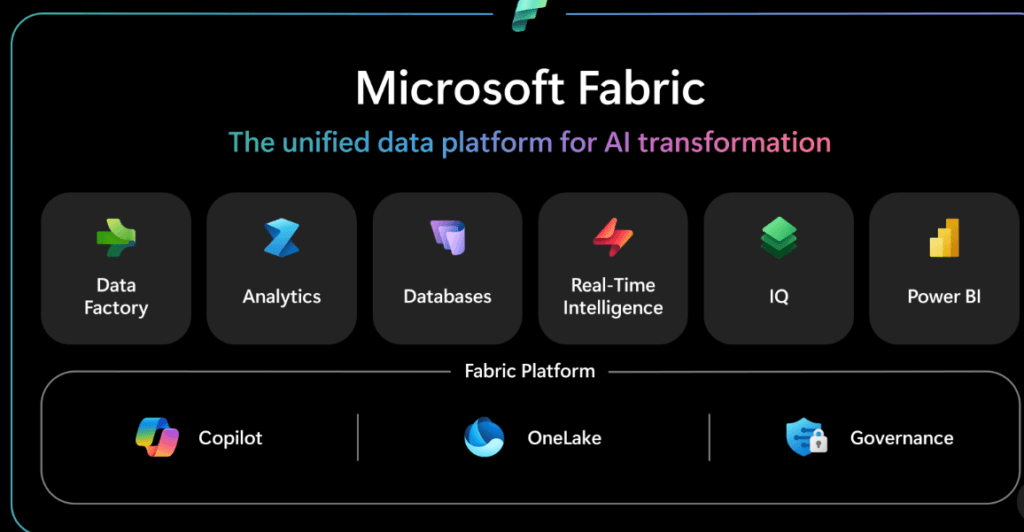
Microsoft Fabric to jedna z tych technologii, o których możesz słyszeć bardzo dużo, zanim w ogóle będziesz wiedzieć, czym dokładnie jest. Microsoft przedstawia Fabric jako platformę analityczną, która obejmuje cały przepływ pracy z danymi: od ich pozyskania i przekształcenia, przez przechowywanie i analizę, aż po raportowanie. Całość działa jako usługa SaaS w chmurze i opiera się na wspólnej warstwie danych, czyli OneLake.
Brzmi dość szeroko. I właśnie takie jest pierwsze wrażenie z Fabric. Zamiast jednego programu dostajesz platformę, w której znajduje się wiele różnych obszarów. Dlatego najlepiej nie zaczynać od zapamiętywania nazw. Zacznijmy od tego, jaki problem Fabric właściwie próbuje rozwiązać.
Dlaczego powstał Microsoft Fabric?
W pracy z danymi mamy zwykle kilka różnych etapów. Dane znajdują się w bazach, plikach, systemach firmowych czy np. API. Trzeba je pobrać, oczyścić, przekształcić, gdzieś przechować, przygotować do analizy, a później stworzyć raport lub model.
Przez lata różne elementy tego procesu mogły być realizowane za pomocą różnych usług. Microsoft miał między innymi Power BI, Azure Data Factory czy Azure Synapse. Każda z tych usług miała swoje zadanie.
Fabric łączy wiele tych możliwości w jednym środowisku. Chodzi więc nie tylko o kolejne narzędzie do analizy danych, ale o zintegrowaną platformę obejmującą cały cykl pracy z danymi.
Można to bardzo mocno uprościć do jednego schematu:
Źródła danych → OneLake → przygotowanie danych → przechowywanie → modelowanie → Power BI → raport
I teraz każdy z tych elementów możemy rozłożyć na części.
Źródła danych
Na początku są oczywiście dane.
Mogą pochodzić z Excela, SQL, API, SharePointa, systemu ERP, CRM czy wielu innych źródeł. Data Factory w Fabric ma setki konektorów i służy między innymi do łączenia się ze źródłami, przenoszenia danych oraz ich transformacji.
Nie ma tutaj nic szczególnie magicznego. To po prostu miejsce, w którym dane powstają albo są już przechowywane.
OneLake
Kolejnym ważnym elementem jest OneLake.
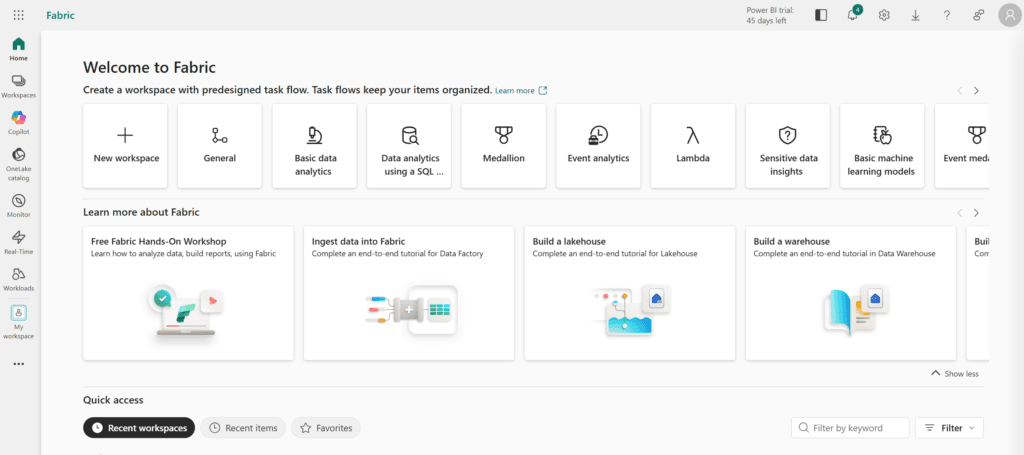
To wspólna, logiczna warstwa przechowywania danych dla całej organizacji w Fabric. OneLake jest dostępny w ramach Fabric i stanowi wspólną podstawę dla różnych workloadów platformy.
Najłatwiej myśleć o nim jako o jednym wspólnym miejscu na dane.
I to jest ważne, ponieważ różne elementy Fabric mogą pracować na danych znajdujących się w tej samej warstwie. Microsoft opisuje to jako sposób na ograniczenie silosów danych i niepotrzebnego kopiowania danych pomiędzy kolejnymi usługami.
Data Factory
Data Factory odpowiada za integrację danych. W praktyce pomaga pobierać dane ze źródeł, przenosić je, przekształcać i automatyzować procesy.
W ramach Data Factory znajdziesz między innymi Dataflow Gen2 i Pipeline.
Dataflow Gen2
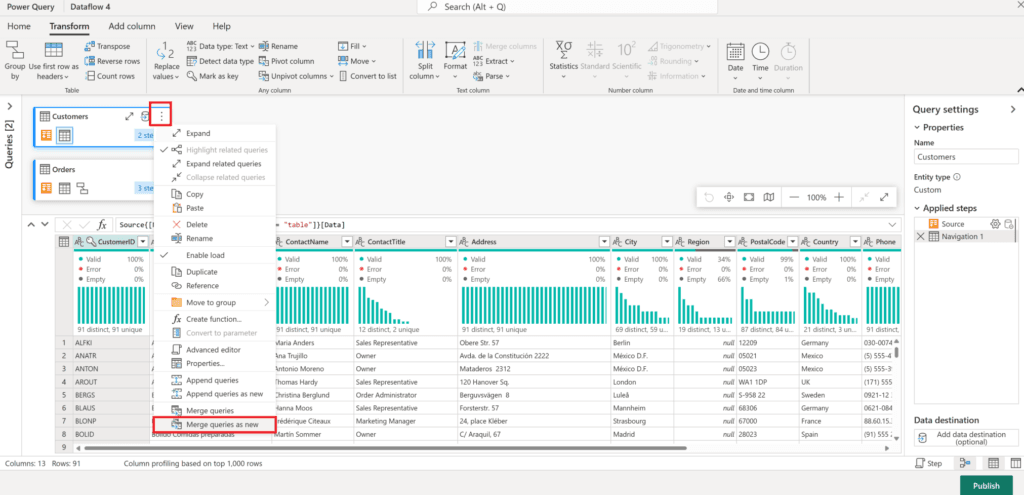
Dataflow Gen2 służy przede wszystkim do przygotowywania i przekształcania danych. Jeżeli znasz Power Query z Power BI, jego sposób działania będzie bardzo znajomy. Możesz pobrać dane, oczyścić je, połączyć tabele, zmienić ich strukturę i przygotować je do dalszej pracy.
Czyli w skrócie:
Dataflow Gen2 = transformacja danych.
To właśnie dlatego jest ciekawym punktem wejścia dla analityków danych.
Pipeline
Pipeline ma trochę inną rolę. Nie chodzi tutaj przede wszystkim o samo czyszczenie danych, tylko o zarządzanie całym procesem. Możesz ustawić, że najpierw mają zostać pobrane dane, później uruchomiony Dataflow, następnie wykonane kolejne zadanie, a na końcu odświeżony model.
Pipeline może również działać według harmonogramu albo reagować na określone zdarzenia.
Najprościej:
Dataflow = co robimy z danymi.
Pipeline = jak łączymy i automatyzujemy kolejne kroki.
Lakehouse
Kiedy dane są już pobrane i przygotowane, trzeba je gdzieś przechowywać. Jedną z możliwości w Fabric jest Lakehouse.
Lakehouse łączy elementy podejścia data lake z możliwościami potrzebnymi do analityki. Można na nim pracować między innymi z wykorzystaniem Spark i SQL. Nie musisz jednak na początku znać wszystkich szczegółów architektury Lakehouse.
Wystarczy rozumieć jego miejsce w całym procesie:
dane trafiają do Lakehouse i mogą być tam dalej przetwarzane oraz analizowane.
Warehouse
Drugą możliwością jest Data Warehouse. Jeżeli znasz klasyczne hurtownie danych i SQL, ten element będzie prawdopodobnie bardziej znajomy. Warehouse jest przeznaczony do pracy z danymi w architekturze hurtowni i mocno opiera się na SQL.
Lakehouse i Warehouse nie są po prostu dwoma identycznymi narzędziami z różnymi nazwami. Są przeznaczone do trochę innych scenariuszy i wybór zależy od konkretnego rozwiązania.
Na początku naprawdę wystarczy wiedzieć, że Fabric daje różne możliwości przechowywania i pracy z danymi.
Model semantyczny
Kiedy dane są już przygotowane, kolejnym krokiem może być stworzenie modelu semantycznego.
Jeżeli pracujesz z Power BI, wiele rzeczy będzie tutaj znajomych. Model semantyczny pozwala zdefiniować między innymi relacje, miary, logikę biznesową i sposób, w jaki dane będą wykorzystywane podczas analizy.
To właśnie tutaj surowe dane zaczynają być przygotowywane w sposób, który ma sens dla użytkownika biznesowego.
Power BI
I na końcu mamy coś, co wielu analityków zna już bardzo dobrze. Power BI jest częścią Microsoft Fabric. Nie musisz więc traktować Fabric jako następcy Power BI. Power BI nadal odpowiada za analizę, wizualizację i raportowanie, tylko znajduje się teraz w znacznie szerszym ekosystemie.
Możesz więc spojrzeć na cały proces mniej więcej tak:
Źródło → OneLake → Data Factory → Lakehouse / Warehouse → model semantyczny → Power BI
Oczywiście rzeczywiste projekty mogą wyglądać znacznie bardziej skomplikowanie. Ale ten prosty obraz wystarczy, żeby zacząć rozumieć, gdzie poszczególne elementy Fabric mają swoje miejsce. A jeśli zastanawiasz się co pojawiło się w najnowszych aktualizacjach w PBI to znajdziesz sporo wpisów na blogu o tym.
A co z Data Engineering, Data Science i innymi workloadami?
Fabric jest dużo większy niż ten jeden przepływ. Platforma obejmuje między innymi Data Engineering, Data Science, Data Warehouse, Data Factory, Real-Time Intelligence i Power BI. Każdy z tych obszarów jest przeznaczony do trochę innych zadań.
Data Engineering pozwala między innymi pracować z Lakehouse, notebookami i Spark.
Data Science służy do budowania i wdrażania modeli uczenia maszynowego.
Real-Time Intelligence skupia się na danych napływających w czasie rzeczywistym.
I tutaj pojawia się jedna z najważniejszych rzeczy, które warto zrozumieć: nie musisz znać wszystkich workloadów. Jeżeli jesteś analitykiem danych, prawdopodobnie nie będziesz potrzebować całego Fabric w takim samym stopniu jak Data Engineer czy Data Scientist. Technologię warto poznawać pod kątem problemów, które rzeczywiście chcesz rozwiązywać.
Czy Fabric jest dla analityka danych?
Tak, ale zakres wykorzystania będzie zależał od konkretnej roli. Analityk pracujący głównie z Power BI może potrzebować przede wszystkim zrozumieć, jak dane trafiają do modelu, czym jest OneLake i jak działają podstawowe elementy integracji danych.
BI Developer może wejść głębiej w modele, hurtownie i automatyzację.
Analytics Engineer czy Data Engineer będzie prawdopodobnie potrzebował znacznie większej części całego ekosystemu.
Dlatego nie powiedziałabym, że „każdy analityk musi znać Microsoft Fabric”. Powiedziałabym raczej: warto wiedzieć, czym jest Fabric i rozumieć jego podstawową architekturę. A później dobierać kolejne elementy do swojej pracy.
Od czego zacząć naukę?
Jeżeli dopiero zaczynasz, proponuję taką kolejność:
1. Zrozum, po co powstał Fabric.
Nie zaczynaj od Sparka ani od listy wszystkich dostępnych funkcji.
2. Zrozum OneLake.
Wystarczy wiedzieć, że jest to wspólna warstwa danych dla Fabric.
3. Zobacz cały przepływ danych.
Skąd dane przychodzą, gdzie trafiają, jak są przekształcane i jak ostatecznie docierają do raportu.
4. Poznaj Dataflow Gen2 i Pipeline.
Zwłaszcza jeśli znasz już Power Query.
5. Dopiero później zagłębiaj się w Lakehouse i Warehouse.
A kiedy pojawi się konkretny projekt, możesz wejść głębiej w Notebooki, Spark, Data Engineering, Data Science czy inne obszary. To podejście pozwala uniknąć sytuacji, w której po pierwszych kilku stronach dokumentacji masz zapisanych 20 nowych pojęć i nie wiesz, które z nich są Ci właściwie potrzebne.
Na koniec
Sama dopiero uczę się Microsoft Fabric. I właśnie z tej perspektywy nagrałam też film na YouTube, w którym pokazuję moje pierwsze zderzenie z Fabric, książkę, od której zaczęłam, oraz to, jak próbuję zdecydować, czego uczyć się teraz, a co zostawić na później.
🎥 Microsoft Fabric od zera. Co naprawdę warto zrozumieć na początku?
Lub do odsłuchania na Spotify

